Ob Politiker, Schauspieler oder andere Prominente: Wenn wir sie in Bildern oder Videos sehen, können wir nicht mehr sicher sein, dass diese Aufnahmen echt sind. Denn künstliche Intelligenz kann inzwischen täuschend echte Deepfakes erzeugen. In Videos erscheint dann nicht nur die Person lebensecht, auch ihre Stimme und Sprechweise ahmen die KI-Modelle nach. Viele dieser Deepfakes sind für uns Menschen nicht mehr als solche erkennbar.
Das Problem der Deepfake-Fahnder
Doch nicht nur wir Menschen haben mit solchen Deepfakes Schwierigkeiten: Auch eigens auf solche Fälschungen trainierte KI-Systeme scheitern zunehmend. Einer der Gründe: Beim Training solcher Deepfake-Detektoren ist ein Kompromiss nötig. KI-Modelle, die die typischen Kennzeichen gängiger Deepfakes anhand großer Datensätze lernen, sind zwar sehr treffsicher. Dafür übersehen sie aber oft Fälschungen, deren Merkmale nicht in ihren Trainingsdatensätzen vorkamen.
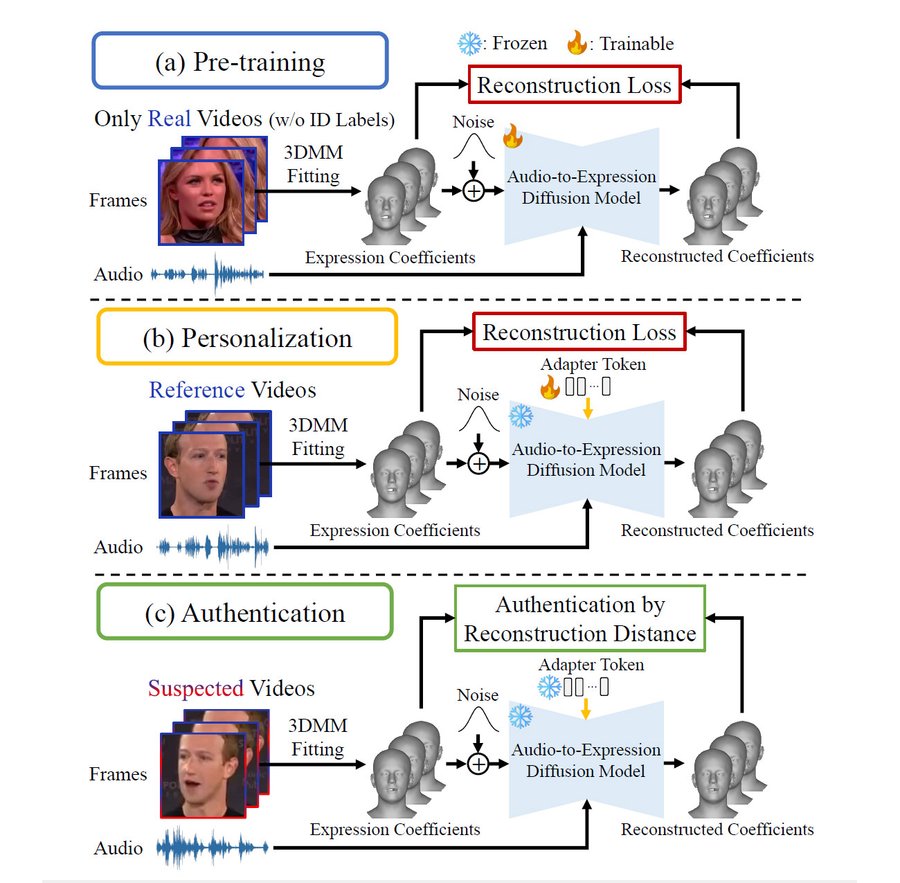
Die Alternative ist das Training solcher Fake-Detektoren durch selbstüberwachtes Lernen (self-supervised learning). Dabei bekommt die KI ausschließlich echte Videos und soll daraus selbst extrahieren, welche Merkmale solche Originale auszeichnen. „Solche Modelle bieten mehr Potenzial für die generalisierte Erkennung, tun sich aber oft schwer damit, die Unterscheidungsmerkmale allein durch selbstüberachtes Training zu lernen“, erklären Kaede Shiohara von der Universität Tokio und seine Kollegen.
So funktioniert das Training des neuen Deepfake-Detektors
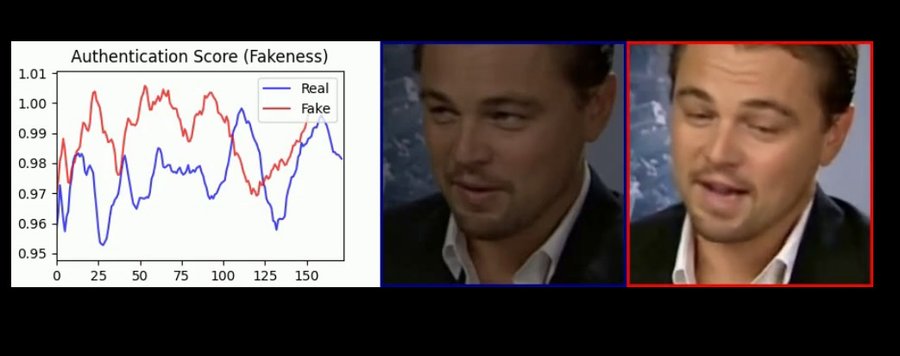
Deshalb haben Shiohara und sein Team nun einen neuen Fake-Video-Detektor entwickelt. Er beruht zwar auch auf selbstüberwachtem Lernen, setzt aber an anderen Erkennungsmerkmalen an: Statt nach Auffälligkeiten auf Pixelebene zu suchen, konzentriert sich das „ExposeAnyone“ getaufte KI-Modell auf die Mimik der dargestellten Person beim Sprechen. „Wir fokusssieren uns auf die Diskrepanzen, die bei echten und gefakten sprechenden Subjekten auftreten“, erklären die Forscher.