
Unser Erbgut besteht nur zu zwei Prozent aus proteinkodierenden Genen. Diese Abschnitte enthalten die Bauanleitung für die rund 19.500 Proteine, die für unsere Zellfunktionen unverzichtbar sind. Doch was macht der große Rest unserer DNA? Lange galten diese Sequenzen unbekannter Funktion als bloße Genkopien oder funktionslose Relikte. Doch inzwischen ist klar, dass viele dieser nichtkodierenden DNA-Abschnitte wichtige Funktionen haben, beispielsweise für die Genregulation. Einige dieser DNA-Sequenzen werden zudem von der Zellmaschinerie abgelesen und möglicherweise auch in Moleküle „übersetzt“.
Spurensuche im „Dunklen Proteom“
Doch bisher blieb unklar, in welchem Maße die außerhalb der Gene liegenden „nichtkanonischen offenen Leserahmen“ (ncORF) unseres Erbguts Moleküle produzieren und welche. Es gab aber erste Hinweise darauf, dass aus Aminosäuren aufgebaute Peptidketten darunter sein könnten. „Diese ncORFs und die von ihnen kodierten Polypeptide gelten daher auch als Teil des ‚Dunklen Proteoms‘“, erklären Eric Deutsch vom Institute for Systems Biology in Seattle und seine Kollegen.
Um mehr Licht in dieses „Dunkle Proteom“ zu bringen, haben Deutsch und seine Kollegen 7264 dieser nichtkanonischen offenen Leserahmen in der menschlichen DNA genauer untersucht. Im Rahmen des internationalen TransCODE-Konsortiums sequenzierten sie die DNA-Abschnitte, analysierten die in Zellkulturen daraus abgelesenen und erzeugten Moleküle und suchten nach möglichen biologischen Funktionen.
1.785 zuvor unbekannte Mikroproteine
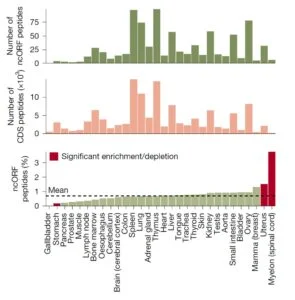
Das Ergebnis: „Rund 25 Prozent der von uns untersuchten nichtkanonischen offenen Leserahmen bringen detektierbare Peptide hervor“, berichten die Forschenden. Die zuvor als weitgehend funktionslos betrachteten DNA-Abschnitte enthalten demnach die Bauanleitung für 1.785 zuvor unbekannte Mikroproteine – Moleküle aus aneinandergereihten Aminosäuren. Die meisten dieser Peptidketten sind allerdings deutlich kürzer als bei normalen Proteinen – zwei Drittel von ihnen enthalten weniger als 50 Aminosäuren.


