
Künstliche Intelligenz ist längst in unserem Alltag angekommen und gewinnt auch in Wirtschaft und Technik immer mehr an Bedeutung. Doch trotz enormer Fortschritte der neuronalen Netzwerke und KI-Modelle bleibt ein Problem bestehen: Das Verhalten von KI-Systemen ist notorisch schwer zu steuern und vorherzusagen. Selbst wenn identische Modelle auf die gleiche Weise und mit denselben Daten trainiert werden, verhalten sie sich am Ende leicht unterschiedlich. Ihre Antworten sind nicht hundertprozentig konsistent und zuverlässig.
Aber warum? „Der Mechanismus hinter dieser Unberechenbarkeit des Deep Learning ist bislang unklar“, erklären Andrew Ly und Pulin Gong von der University of Sydney. Bislang schreiben KI-Forscher solche Abweichungen meist externen, größtenteils zufälligen Faktoren zu, beispielsweise Schwankungen in der Hardwareleistung der Prozessoren, winzigen Fehlern beim Einlesen der Daten oder Unterschiede in deren Reihenfolge. Gleiche KI-Modelle, bei denen dieses „Störrauschen“ verringert wurde, müssten sich demnach ähnlicher sein – das ist aber nicht der Fall, wie Ly und Gong erklären.
KI-Training als fraktale Landkarte
Auf der Suche nach einer Erklärung haben sich die Physiker daher den mathematischen Hintergrund des Deep Learnings genauer angeschaut – die Gleichungen, die beschreiben, was beim Training einer künstlichen Intelligenz in ihrem Netzwerk geschieht. Die Forscher veranschaulichen dies mit der Analogie einer Landkarte: Jeder Punkt in der Karte entspricht dem Ausgangspunkt eines Trainingsprozesses, die Farbe der Punkte kennzeichnet das später erzielte Ergebnis.
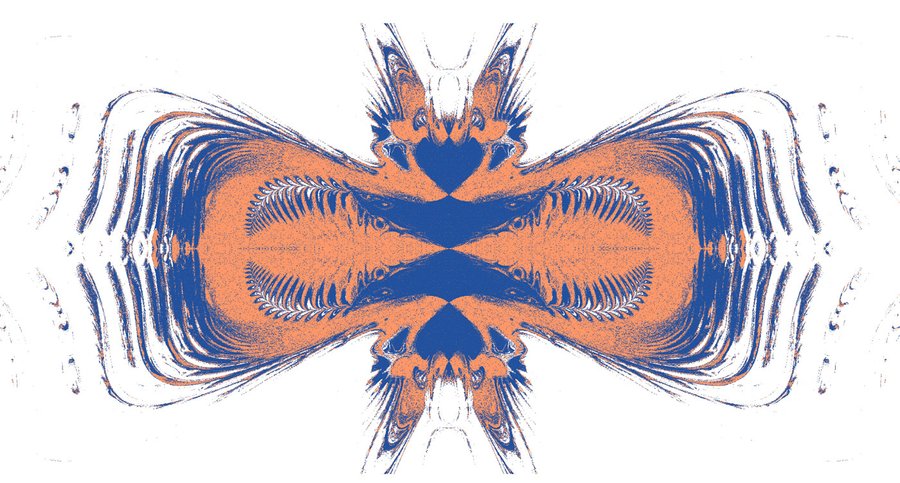
Fraktale Lernlandschaft: Jeder farbige Punkt steht für eine Anfangskonfiguration eines KI-Modells: Blau führt zu einem Trainingsergebnis, Orange zu einem anderen. — © Pulin Gong/The University of Sydney
Gängiger Annahme nach entspricht diese mathematische Trainingslandschaft sogenannten „mageren“ Fraktalen: Ob ein KI-Modell seine Parameter auf die eine oder andere Weise anpasst, lässt sich demnach mathematisch klar abgrenzen. In dieser Landkarte ziehen sich Punkte gleicher Farbe an und kombinieren sich zu größeren Flächen mit klaren Grenzen – wie in einer klassischen Fraktaldarstellung. „Wenn man in einem solchen System die Unsicherheit in den Anfangsbedingungen genügend reduziert, kann man das Resultat vorhersagen“, erklärt das Team.
Unendlich durchlöchert
Doch den neuen Analysen zufolge sieht die Trainingslandschaft gängiger KI-Systeme anders aus: Sie ähnelt einem „fetten“ Fraktal, auch als zerfurchtes Becken bezeichnet. „Die Einzugsbereiche, die im Parameterraum die Trainingsergebnisse bestimmen, sind dabei derart ineinander verschachtelt, dass jede Initialisierung beliebig nahe an Initialisierungen liegt, die zu einer anderen Lösung führen“, berichten Ly und Gong. In der Landkarte sind die Punkte derart durchmischt, dass es keine klaren Flächen oder Grenzen mehr gibt.
Selbst wenn man in dieser „fetten“ Fraktallandschaft immer weiter reinzoomt, entwirren sich diese Punkte nicht: Man findet keine glatte Fläche oder Kante, das gesamte Gewebe bleibt in allen Maßstäben durchlöchert. Für das KI-Training bedeutet dies: Eine winzige Abweichung – kleiner als ein Atom – kann das KI-Modell in das Einzugsgebiet des jeweils anderen Zustands bringen. Das macht den Prozess maximal unvorhersagbar: „Selbst eine Erhöhung der Genauigkeit ermöglicht keine zuverlässige Vorhersage des Trainingsergebnisses mehr“, schreiben die Forscher.
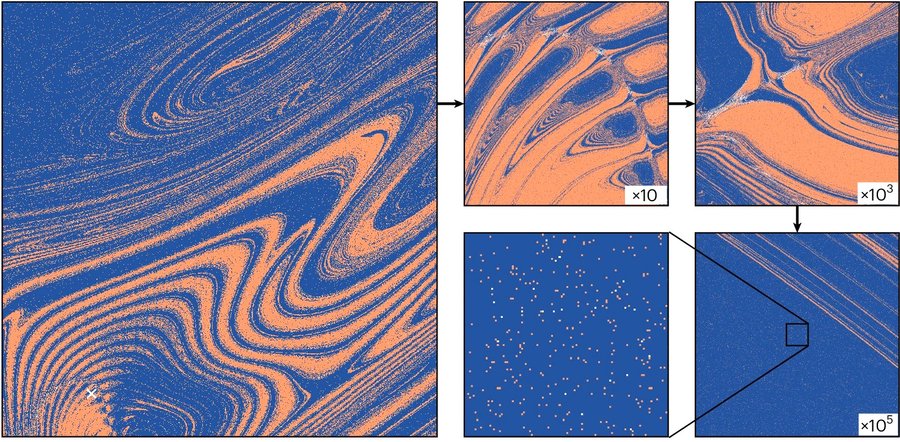
Egal, wie weit man reinzoomt: Im „fetten“ Fraktal gibt es keine sauberen Kanten oder Flächen: Immer sind fremdfarbige Punkte eingestreut. — © Ly und Pulin/ Nature Machine Intelligence, CC-by 4.0
Fette Fraktale bei allen KI-Formen und Parametergrößen
Um ihre Theorie zu überprüfen, trainierten die Forscher rund 500.000 neuronale Netze und analysierten Systeme, die unter anderem für Bilderkennung und Textverarbeitung eingesetzt werden. Dabei fanden sie über verschiedenste Netzwerkarchitekturen, Datensätze und Trainingsmethoden hinweg immer wieder Belege für diese fraktale Struktur. Sie ist zudem skalenunabhängig: Sie tritt bei großen KI-Modellen mit Milliarden Parametern genauso auf wie bei kleinen neuronalen Netzen mit nur zwei Schichten.
Die fetten Fraktale erklären, warum KI-Modelle selbst bei maximal übereinstimmenden Anfangseinstellungen und präziser Kontrolle aller Störfaktoren niemals völlig identisch werden können: Die grundlegende Mathematik ihres Lernprozesses erlaubt keine vollständige Reproduzierbarkeit und Vorhersage. In Tests mit einer auf Bilderkennung trainierten KI verbesserte selbst eine zehn Milliarden Mal höhere Präzision der Anfangseinstellungen die Reproduzierbarkeit nicht.
Konflikt zwischen Leistung und Reproduzierbarkeit
Doch es gibt einen Weg, die Unwägbarkeiten zu reduzieren: Indem man die Lernrate der künstlichen Intelligenz im Training verringert. Die Lernrate bestimmt, wie stark das neuronale Netzwerk seine Parameter bei jedem Lernschritt anpasst und verändert. „Bei geringeren Lernraten werden die Parameterräume und Funktionen reproduzierbarer“, berichten Ly und Gong. Allerdings geht dies zu Lasten der KI-Leistung: Die KI-Modelle lernen beim Training weniger effektiv und schnell.
Mit anderen Worten: Beim Training von KI-Modellen gibt es einen grundlegenden Konflikt zwischen Reproduktivität und Leistung. Die Einstellungen, durch die neuronale Netze am effektivsten lernen, machen ihre Ergebnisse unberechenbarer. Allerdings muss das nicht so bleiben, wie die Forscher erklären: Wenn man die Netzwerkarchitekturen der gängigen KI-Systeme grundlegend umgestaltet, könnte man diese Zwickmühle umgehen.
Wie geht es weiter?
Nach Ansicht der Forscher liefern ihre Ergebnisse nicht nur eine Antwort darauf, warum künstliche Intelligenzen so unberechenbar sind – sie könnten auch dabei helfen, zuverlässigere Systeme zu entwickeln. Dies ist vor allem dort wichtig, wo KI-Systeme essenzielle Funktionen übernehmen, wie beispielsweise in der Medizin, in Behörden, Justiz und Finanzwesen oder in der Wirtschaft.
„Künstliche Intelligenz gewinnt in immer mehr gesellschaftlichen Bereichen an Bedeutung“, sagt Gong. „Um vertrauenswürdige Systeme zu entwickeln, benötigen wir nicht nur präzise Vorhersagen, sondern auch die Gewissheit, dass diese Vorhersagen reproduzierbar sind. Diese Forschung eröffnet eine neue Perspektive auf die Grenzen der Vorhersagbarkeit von KI und darauf, wie wir diese möglicherweise überwinden können.“
Quelle: Andrew Ly und Pulin Gong (University of Sydney), Nature Machine Intelligence, 2026; doi: 10.1038/s42256-026-01336-3


